缘起#
全国大学生开源情报数据采集与分析大赛,我挑的题目是「全球极端天气与自然灾害加剧背景下的气候危机情报分析」。选它一半是因为关心气候,一半是看着这个题目觉得公开数据够多、能挖出东西——后面这半理由后来被我推翻了。
真正动手前,我以为难点是数据不好找。下载一圈才明白:难的不是少,是彼此对不上号。同一个国家,一个库里叫 Syria,另一个库里叫 Syrian Arab Republic;斯威士兰在一份 2021 年的快照里还写着 Swaziland,而它 2018 年就改名了;同一场洪水在不同库里挂着三四个编号;连"强度"这个词都不统一——野火用它指过火面积,地震用它指震级,再保险报告用它指赔了多少钱。
这些错位不会报错,只会安静地把结论带偏。所以"对口径"占掉了这次工作的一大半,我把每一次踩坑都单独记了下来。下面按三个可证伪的问题来讲。
三个必须可证伪的问题#
我不打算做"灾害地图 + 频次柱状图 + 损失排行榜"——那类图很直观,但读完不会多知道任何东西。真正想回答的是三个能被数据推翻的问题:
| 编号 | 命题 | 如果成立意味着什么 |
|---|---|---|
| H1 | 损失增速快于频次增速 | 单次事件在变贵,说明暴露度或脆弱性在上升,而不只是灾害变多 |
| H2 | 复合灾害的损失超线性 | 多灾种同时发生时损失大于各自单独发生之和(1+1 > 2) |
| H3 | 传导链存在可测量的时滞与放大 | 灾害沿迁移、贸易、粮食、卫生四条链传导,且在脆弱地区被放大 |
三条都必须可证伪:数据显示不支持就写证伪,样本不够就写"不可识别",不硬凑结论。
数据与方法#
15 个数据源、283,502 条结构化记录,覆盖灾害事件、经济损失、人口流离失所、贸易流、粮食价格、公共卫生与气候指数。来源按可信度分四级(官方一手 / 国际组织标准化事件库 / 行业估算 / 聚合二手),同一指标只用一个主源参与计算,其余仅作交叉校验——EM-DAT、Aon 再保险、GDACS 模型三套损失口径混算,得到的数字没有任何意义。
整套采集与分析工具链是自己写的(59 个模块、8,244 行代码),分七层:环境层(修网络栈)→ 采集层(限流、重试、退避)→ 快照层(每个原始响应按 SHA256 内容寻址归档,约 400 MB)→ 解析层 → 存储层 → 指标层 → 分析层。任何结论都能回溯到原始字节,请求日志会自动过滤掉 api_key、mailto 这类凭据参数。
为什么必须自建"强度标尺"#
这是整个分析里最关键的一步。各灾害库自报的强度互不可比:GDACS 对洪水的 severity 实测恒为 0,野火用"过火 8718 公顷",地震用震级,再保险报告用损失金额。把它们直接塞进同一个模型,"复合灾害是否超线性"这个问题根本无法回答。
我的做法是给每个事件点位取 NASA POWER 的逐日气温、降水、风速,以及该点位 1991–2020 的完整历史序列(按 0.5° 网格缓存),把强度统一表达为相对于同日历窗口历史分布的超越倍数。
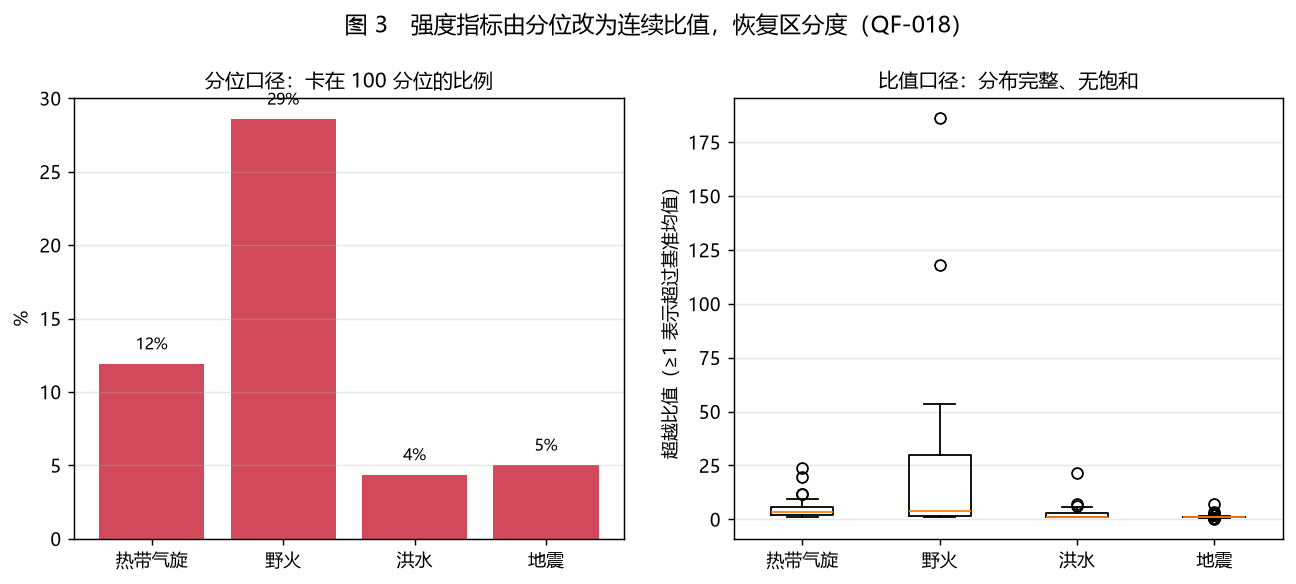
这里踩过一个方法论坑,值得记下来:第一版用"事件窗口最大值在全部历史日中的分位"当强度,结果台风的中位数卡在 100 分位——窗口越长越容易取到极值,跨事件根本不可比。改成区块极值口径后仍有 59.5% 的台风堆在上界、失去区分度。最终换成连续型超越比值(事件窗口聚合值 ÷ 基准期同长度窗口均值),台风强度分布才从中位 100 分位变成中位 3.4、区间 1.0–23.6。
这一步不是技术洁癖:六成样本取同一个值,剂量—响应关系就是无法估计的,H2 会直接得出"强度不影响损失"的假结论。
结果一:损失的上升来自"变多",不是"变贵"#
| 层次 | 年增速 | R² | t | 判读 |
|---|---|---|---|---|
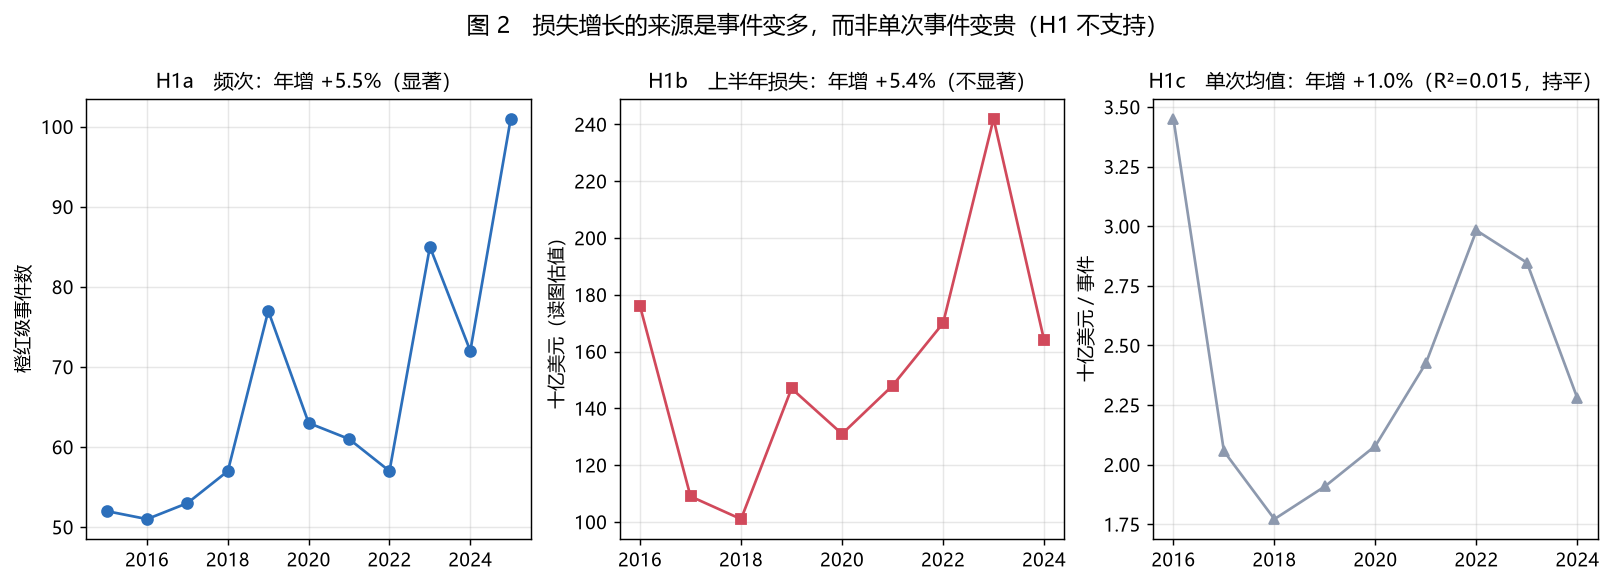
| H1a 频次(橙红级事件) | +5.49% | 0.636 | 3.96 | 显著上升 |
| H1b 经济损失 | +5.41% | 0.299 | 1.73 | 不显著 |
| H1c 单次事件均值 | +1.00% | 0.015 | — | 持平 |
裁定:H1 不支持。 损失增速(+5.4%)与频次增速(+5.5%)几乎相同,而单次事件平均损失年增只有 1.0%、解释力 R²=0.015,等于没有趋势。
也就是说:灾害总损失的上升,几乎完全由"事件变多"驱动,而不是单次灾害变得更贵。
稳健性检验四项全部通过,其中一项值得单独说:ENSO(厄尔尼诺)是全球尺度的气候振荡,会同时抬高多类灾害的频次,必须排除"趋势其实来自厄尔尼诺周期"的可能。在回归里加入 ONI 指数后,时间系数不但没有减弱,反而升到年均 +6.68%(t=4.97)——说明频次上升不是 ENSO 造成的。
结果二:复合灾害确实超线性#
用 NOAA Storm Events(美国官方事件级灾害库,2015–2026 共 750,889 条记录,其中 15.2 万条带损失)来检验。复合事件的定义很硬:同一县区、同一天内出现两种以上不同灾种——空间限定到县区、时间限定到日,不依赖任何模糊匹配。
难点在于复合组天然包含更多事件,直接比会出现明显的"复合更高",但那可能只是"事件多"。所以必须控制事件数量后分层比较:
| 每组事件数 | 多灾种中位损失 | 单一灾种中位损失 | 差值 | 秩和 z |
|---|---|---|---|---|
| 2 | $12,000 | $8,000 | +$4,000 | +14.75 |
| 3 | $20,000 | $11,000 | +$9,000 | +11.18 |
| 4 | $23,900 | $14,000 | +$9,900 | +8.10 |
| 5 | $28,000 | $19,000 | +$9,000 | +4.87 |
四个分层全部显著为正,且差值随复合规模递增。
还有一段小插曲:最初用另一份再保险报告里的 13 条复合事件做检验,结论是"不可识别"。同一命题换个数据就得出结论,原因不是结论变了,而是样本量从 13 条变成 19,610 条之后,检验力从不足变为充分。这件事本身说明:"不可识别"要如实报告,不能当成证伪。
适用范围要说清楚:数据来源是美国官方库,结论适用于美国;能否推广到全球,取决于其他地区有没有同等质量的事件级损失数据。
结果三:四条传导链,四种不同的答案#
方法用 Jordà 局部投影 + 双向固定效应(国家、时间),冲击口径是 GDACS 橙红级事件数。
| 链条 | 结果 | 关键数字 |
|---|---|---|
| 灾害流离失所(IDMC,2 万起事件) | 当年强烈,但不持续 | 灾后当年 β=0.519、t=8.86;此后各期迅速归零 |
| 难民与流离失所存量(UNHCR) | 累积过程 | 4 个滞后期全显著,效应量随滞后上升(0.081→0.133) |
| 贸易(Comtrade) | 只在脆弱地区显著 | 最不发达国家灾后第 3 月 β=−0.919(t=−2.14);非最不发达国家 +0.080(不显著) |
| 粮食价格(WFP,91 国 6,208 个国家-月) | 不显著 | 7 个滞后期 0/7 显著 |
| 公共卫生(WHO 霍乱) | 不可识别 | 可估滞后期均不显著,但样本稀疏(中位 9 个观测) |
| 粮食不安全(IPC 分级) | 不可识别 | 仅 19 国、185 个国家-年观测,检验力不足 |
这张表里有两件事比数字本身更重要。
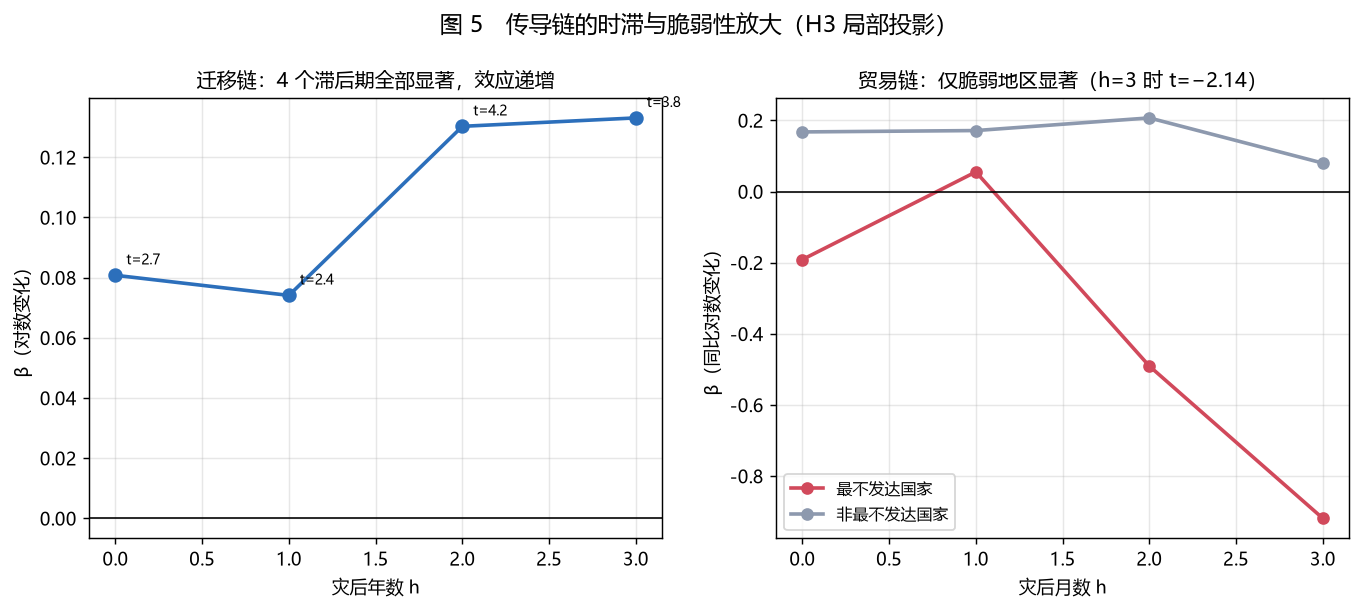
第一,"即时"和"累积"是两种现象,不能混为一谈。 灾害导致的流离失所是当年达峰、次年消失的;而难民存量指标要到第 2–3 年才达峰。如果只看后者,很容易写成"灾害影响持续三年"——正确读法是:存量指标天然累积,灾害本身的迁移冲击是即时完成的。这个区分直接改变对策:救灾安置应当在当年完成,跨境安置规划才需要按三年周期设计。
第二,"全球平均无影响"会掩盖脆弱地区承受的冲击。 贸易链在全样本 7 个滞后期无一显著,按脆弱性分组后差异立刻出现:只有最不发达国家显著为负。分组不是可选项,而是必要步骤。
一个反直觉的发现:中文报道比官方通报慢 6 天#
我原本想验证"中文情报源能不能提前感知灾害"。规则定得很保守:国家一致、灾种一致、时间窗一致(−3 到 +30 天),且灾种判定只看标题(原因见下文那条质量发现)。
| 指标 | 结果 |
|---|---|
| 可匹配事件 | 676 个 |
| 匹配成功 | 153 个(22.6%) |
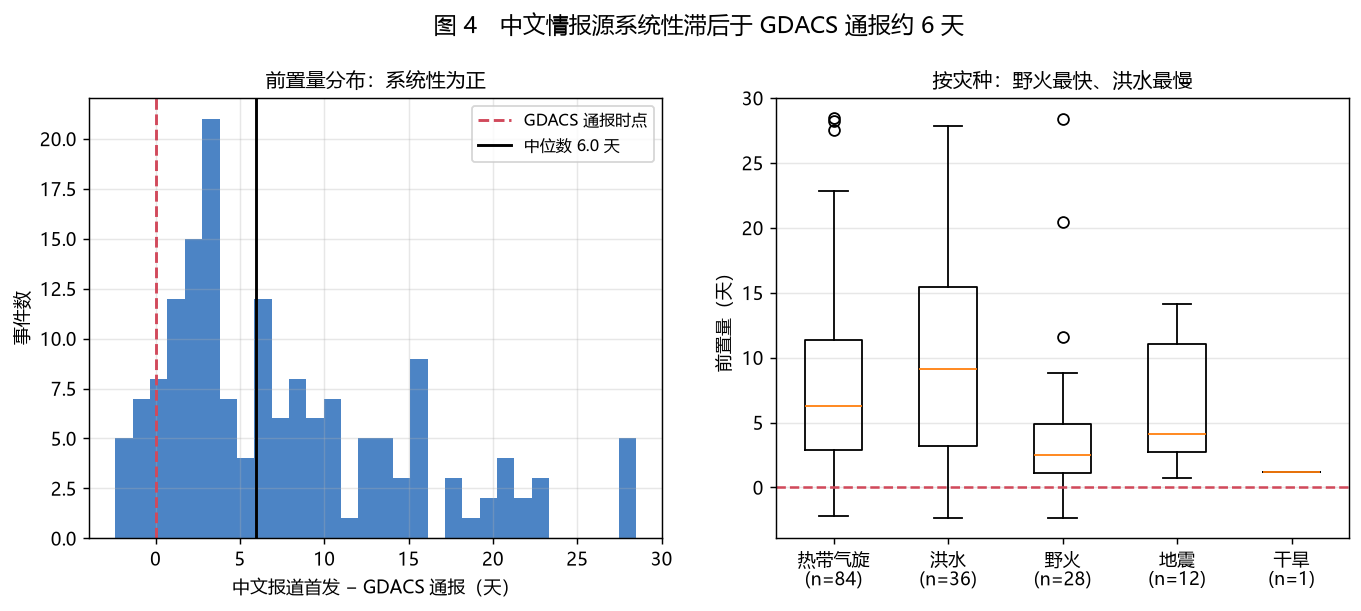
| 前置量中位数 | +143.1 小时(约 6 天) |
| 中文报道早于官方通报 | 仅 9.2% |
结论与初始预期相反:中文报道系统性滞后于官方通报约 6 天,而不是领先。分灾种差异明显:野火中位滞后仅 62.7 小时,显著快于台风(151 小时)与洪水(220 小时)——山火突发、视觉冲击强,洪水成灾有过程延迟。
为确认这不是抽样造成的假象,我定向补采使语料扩大 17.4%,中位数纹丝不动,仍是 143.1 小时。
保守的匹配规则也不等于匹配正确。我按灾种分层抽了 25 条逐条核对,正确率 84%。四类错误各有机制:跨词子串误撞("首台风机"里的"台"和"风"被当成"台风")、否定语境(报道说的是"对该国无影响")、一篇报道被匹配到两起事件、灾种子类混淆(火山性地震被当成构造地震)。中文没有词间空格,子串命中率不能当作准确率——这类判定必须做抽样人工校验。
结果四:中国粮食进口的气候敞口#
把进口集中度与来源国的灾害暴露度交叉,得到一份可以排优先级的清单。覆盖 8 个重点品目、102 个来源国,2016–2024 累计进口额 5,450 亿美元。
最重要的一个数字:大豆的来源集中度是 91.1%(巴西 63.3% + 美国 27.8%),累计进口额 3,759 亿美元。 两个来源国的灾害频率都不高(年均 0.5 与 1.4 次),所以按"灾害频率"排序时它并不靠前——但超过九成的供给集中在两国,任何一国的减产或出口限制都会直接传导。
这说明单一乘积指数不足以为决策排序,它把两类性质不同的风险压缩成了一个数字:
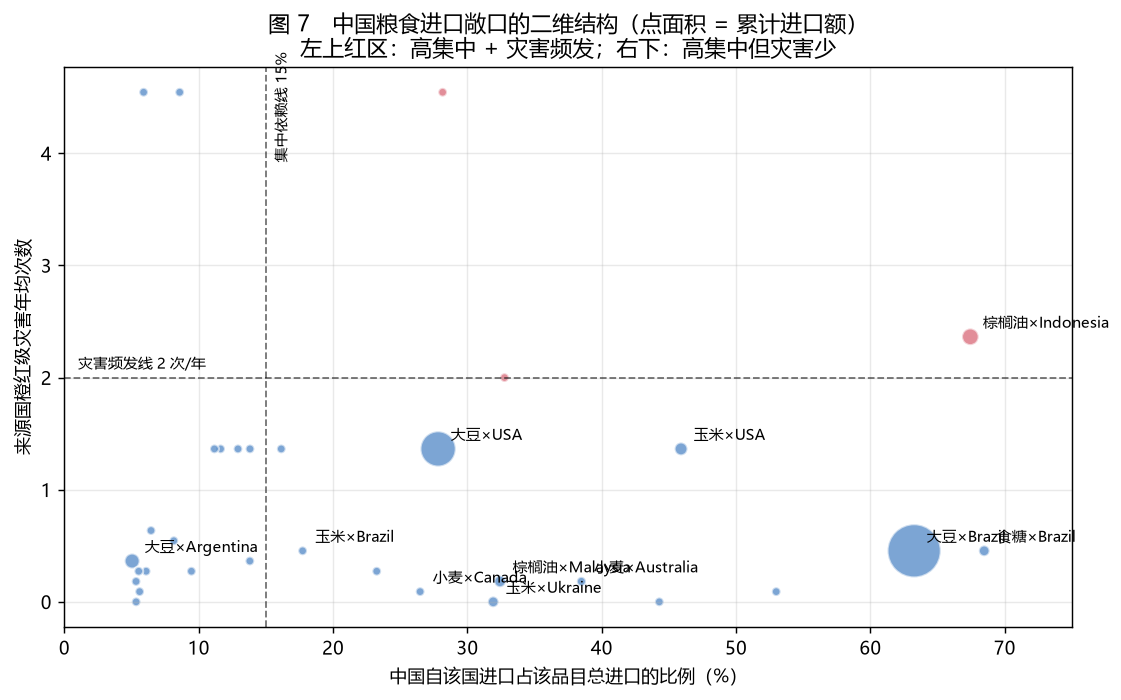
- 来源不稳型(棕榈油 × 印尼 67.4%、豆粕 × 印度 28.2%、稻米 × 越南 32.8%):来源国灾害频发,应对重点是多元化采购与套期保值。
- 依赖过深型(大豆 × 巴西+美国 91.1%、食糖 × 巴西 68.5%):来源国灾害不多,但单一供应国的政策变动或减产会直接传导,应对重点是储备与替代来源培育。
看趋势,画面更清楚:
| 品目 × 来源国 | 2016 | 2024 | 含义 |
|---|---|---|---|
| 食糖 × 巴西 | 60.2% | 86.2% | 静态清单里只排第八,恶化速度最快 |
| 大豆 × 巴西 | 45.8% | 69.1% | 已经很高的集中度仍在向巴西单边倾斜 |
| 玉米 × 巴西 | 0% | 50.3% | 乌克兰来源从 79.7% 崩到 29.5% 后的替代——不是多元化,而是把依赖换了个国家 |
| 稻米 × 越南 | 46.3% | 17.9% | 唯一成功的多元化案例 |
稻米这一行是整节里最乐观的证据:集中度是能被政策改变的,不是必然趋势。
数据质量:这次分析里最有分量的部分#
我把每一条实测发现都按"现象 → 定位过程 → 成因 → 影响 → 应对 → 是否影响结论"记了下来,一共 25 条。以下五条如果不发现,结论会直接错。
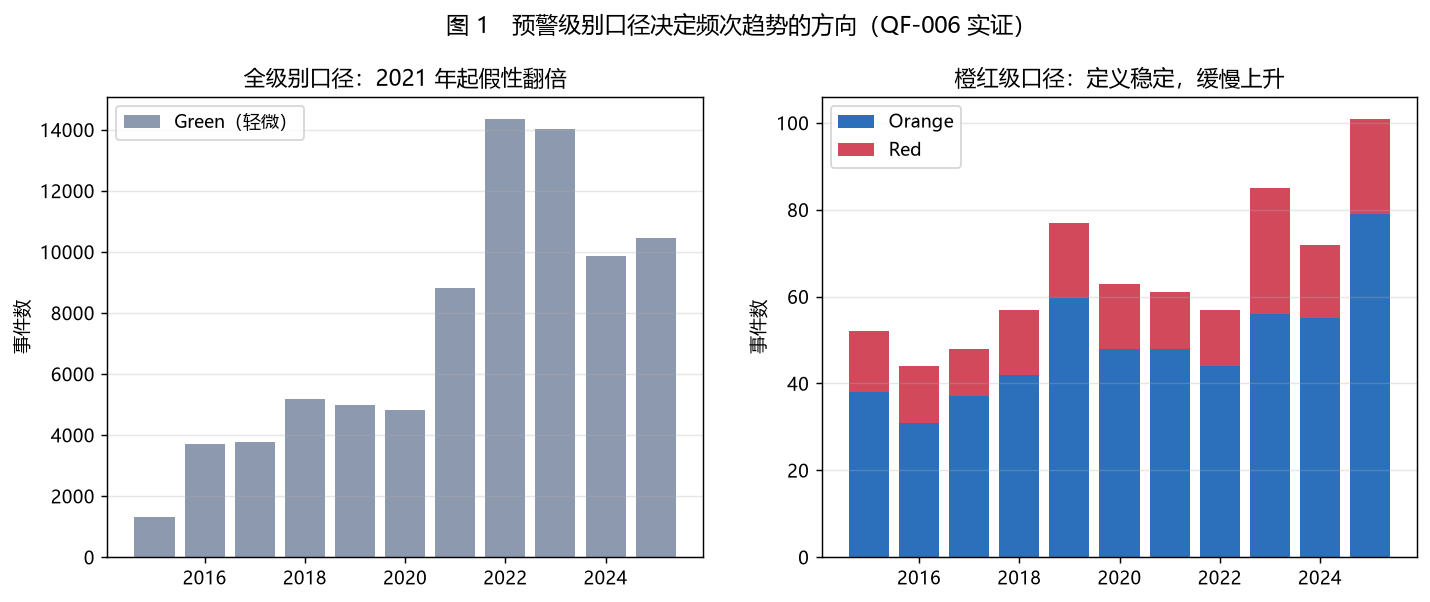
① 预警级别口径让频次相差 135 倍。 GDACS 默认只返回橙/红级事件:2024 年默认口径 74 条,显式包含 Green 级后 10,031 条。逐年对照发现 2020→2021 事件总数从 4,907 跃升到 10,259(+109%),但同期 RED 从 16 降到 13、ORANGE 从 53 降到 50——增量 100% 来自 Green 级,是收录覆盖度扩张,不是灾害变多。不察的话会得出"2021 年全球灾害翻倍"的完全错误结论。
② 自然键缺陷让去重静默失效。 采集器早期版本用 eventid / id / url 猜字段名,而实际字段名是 event_id,于是 15,691 条记录的键为 NULL。而 MySQL 的唯一索引不对 NULL 去重——去重和唯一约束同时失效,同一事件被反复写入(2015 年入库 5,262 条,源端统计 4,862 条,多出的 400 条正好是一次中断运行的页数)。这类缺陷不报任何错误,只会悄悄抬高灾害频次。修复分三层(代码显式传键、schema 置 NOT NULL 加唯一索引、重建缺失键并按来源+键去重,每行删除留审计文件)后,48,450 条降到 45,842 条,NULL 键与重复键组归零。
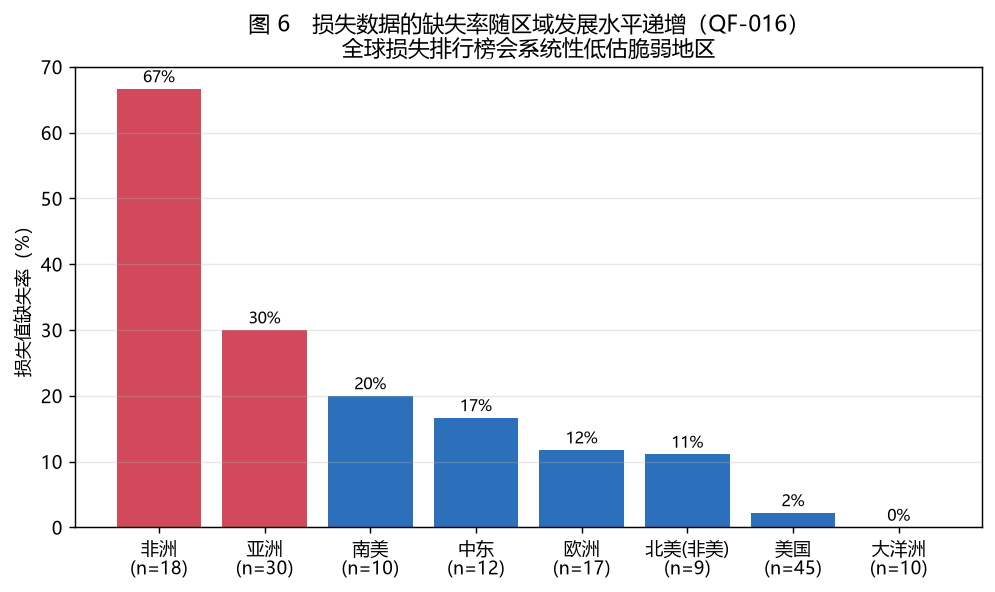
③ 损失数据的缺失率随区域发展水平递增。 再保险报告 151 条事件里 29 条损失为 N/A,但分布极不均匀:非洲 67%、亚洲 30%、欧洲 12%、美国 2%。这不是数据缺陷,而是核心论点之一——损失估算主要覆盖有保险市场、资产登记完整的区域;非洲保险渗透率低,损失根本无法估算。含义有三层:任何全球损失排行榜都系统性低估非洲;直接跨国比较会把报告能力差异当成灾害强度差异;处理缺失时若把 N/A 当 0,非洲损失会被压到近乎为零。所以缺失一律保留为 NULL,绝不填 0。
④ 把检索元数据当成了内容特征。 预警前置量分析的第一版,把「以新换旧和机组退役 中国风电释放巨大运维市场」判成了台风事件。追查发现:判定代码用 标题 + 关键词 拼接做匹配,而关键词就是当初的搜索词,必然出现在自己的记录里——于是"灾种词是否出现"这一检查在任何记录上都成立,等于没有校验。更隐蔽的是,这样匹配数会更漂亮(195 条 vs 修复后 153 条),抽查少量样本未必看得出来。
⑤ 误读了一个列的语义。 首版解析器把 IBTrACS 的 LANDFALL 当作"是否登陆"的布尔标志,算出 PATRICIA 登陆 29 次、SURIGAE 登陆 154 次这种荒谬结果。实测发现该列是距陆地距离(公里),0 才表示在陆地上。改成"数连续为 0 的段数"后:PATRICIA 1 段、GONI 2 段、SURIGAE 0 段(超强台风但全程未登陆,正确)。教训是加一条物理合理性校验:如果统计结果是"所有强台风都多次登陆",那一定是逻辑错了。
三条结论#
一、防灾投入的重点应放在"减少事件发生",而不是"降低单次损失"。 H1 显示单次损失持平、频次显著上升;把资源集中在提高单次抗灾能力,无法对冲事件数增加带来的总损失增长。
二、人口迁移需要跨年度的安置规划。 存量指标在灾后第 2–3 年才达峰,而以"灾后应急"为周期的机制在时间尺度上是错配的。
三、脆弱地区的风险不能由全球平均值代表。 贸易链全样本无影响、最不发达国家显著为负;损失缺失率非洲 67%、美国 2%。两重证据指向同一件事。
局限(诚实声明)#
- 损失序列来自再保险报告图表还原(非发布方原始表格),仅 9 个年度观测、单一来源。因此 H1 的准确表述是"现有证据不支持该假设",而不是强证伪。
- 频次口径仍可能有缓慢的收录扩张,H1a 的 +5.5% 存在被高估的余地。
- 卫生链与粮食不安全链判为"不可识别",不是"无影响"——检验力不足时,正确的写法是不表态。
- 贸易链的 LDC 分组只有 6 个国家,方向稳健但显著性依赖样本构成。
- Comtrade 的伙伴国是申报来源国,可能是转口中转地,不等于原产国。
写在最后#
做完这一轮,我最想留下的其实不是那几条结论,而是两句话。
第一句:数据的口径比数据本身重要。 一份"全球灾害频次"的表,可以因为一个默认参数相差 135 倍;一个"损失排行榜",可以因为缺失率 67% 和 2% 的差别而完全失去可比性。这些问题不会报错,只会安静地把结论带偏。
第二句:报告"不可识别"是结论的一部分。 三个假设里,一个不支持、一个支持、四条传导链里两条不可识别。把不可识别硬写成"无影响",看起来结论更整齐,但那是在丢掉信息。
全部结论由可复现的脚本生成,原始数据快照按 SHA256 归档,采集工具链 59 个模块、8,244 行代码。
还没有评论。